光神经网络:光子人工智能计算的黎明
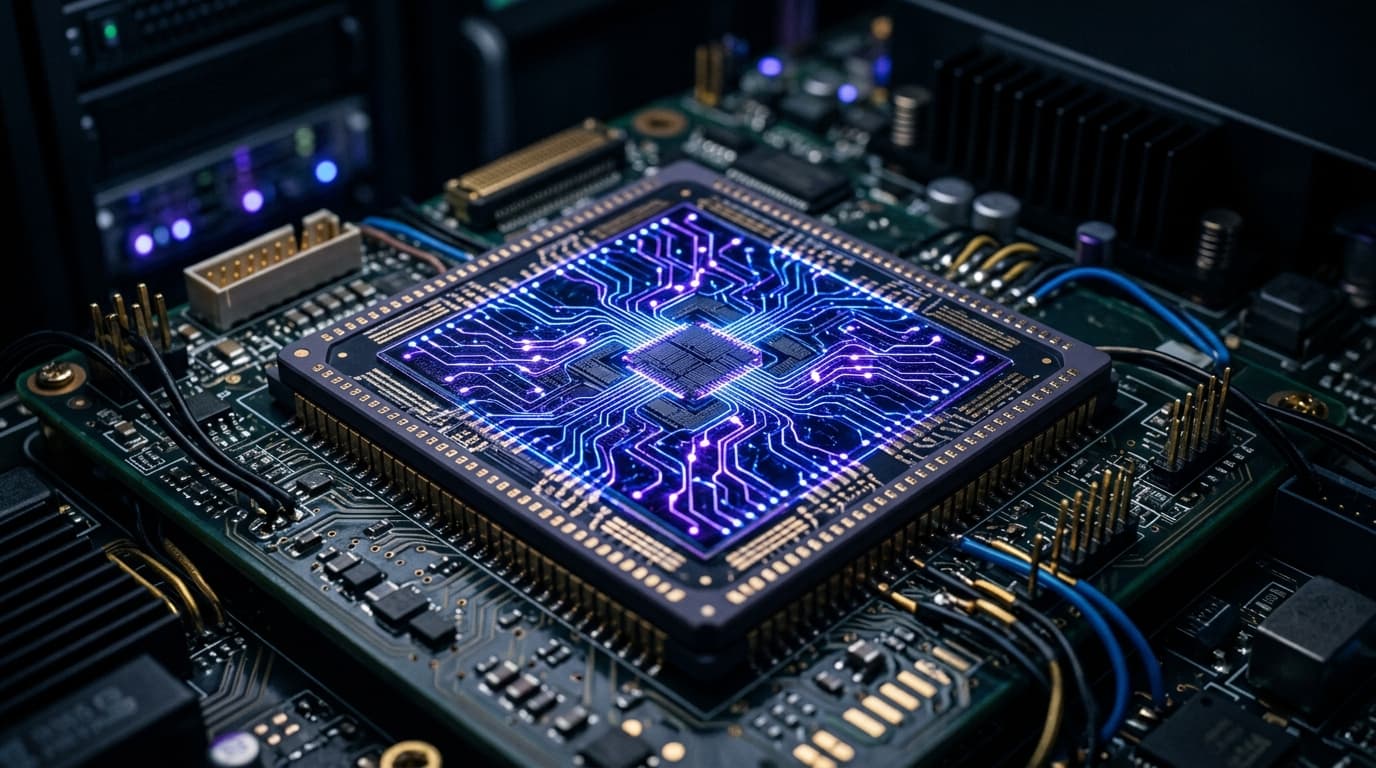
人工智能的爆炸式增长将传统的硅微电子技术推向了物理极限的边缘。现代变压器架构和万亿参数基础模型消耗大量电力,同时产生过多热量,威胁全球数据中心的可持续性。为了突破硅瓶颈,计算机科学家和物理学家转向了一种速度更快的介质:光。由硅光子学驱动的光神经网络 (ONN) 代表了人工智能加速领域的根本性范式转变。
用光子打破摩尔定律
几十年来,计算的进步依赖于根据摩尔定律缩小电子晶体管。然而,随着晶体管尺寸接近原子尺度,量子隧道效应和热耗散对时钟频率施加了严格的物理限制。沿着微观铜互连传输电子不可避免地会产生电阻、延迟和电力浪费。
相比之下,光子不带电荷,并且以光速传播。在光学神经网络中,数学运算(特别是构成深度学习推理大部分的矩阵乘法)是通过光波的物理干涉、衍射和相位调制而不是电子开关来执行的。
通过光进行瞬时矩阵乘法
深度学习模型严重依赖乘法累加 (MAC) 计算。在电子 GPU 中,数百万个逻辑门同时切换,消耗千兆瓦的功率来计算这些线性代数张量。
在光子张量核心中,激光束阵列穿过集成在硅芯片上的马赫-曾德尔干涉仪 (MZI) 网格。通过使用电光材料改变微波导的折射率,该电路可以调制光的相位和强度。当光波从干涉仪阵列中射出时,矩阵乘法已经发生(基本上是瞬时的),且散热量接近于零。
天文数字的能源效率和超低延迟
光学人工智能计算的运营优势是惊人的:
- 亚纳秒延迟: 光以每秒约 80,000 公里的速度穿过硅波导,使得推理速度比铜走线快几个数量级。
- **波分复用(WDM):**可以通过单个光波导在不同颜色(波长)的光上同时进行多个独立计算,而不会产生干扰,从而实现大规模空间并行性。
- 大幅降低热量: 由于光子不产生电阻,光学计算核心保持低温,从而大大降低了目前高密度数据中心的巨大冷却成本。
共封装光学器件和商业化之路
虽然纯光学通用计算机仍在开发中,但混合电光子架构已经找到了商业用途。共封装光学器件 (CPO) 将光子张量引擎与传统内存控制器和 CPU 集成在一起。在这个混合生态系统中,高速光学芯片处理矩阵运算,而经典数字控制器则协调内存访问和非线性激活功能。
随着硅铸造厂制造技术的成熟,光子加速将成为实时边缘机器人、自主航空航天系统和下一代行星级人工智能集群的基础设施。
常见问题解答
光学神经网络与电子 GPU 有何不同?
传统 GPU 使用流过晶体管的电流来执行数学计算,这会产生热量和延迟。光学神经网络使用穿过光学调制器的光束几乎立即计算矩阵方程,而无需电阻。
光学芯片可以运行 PyTorch 和 TensorFlow 等现有的 AI 软件吗?
是的。现代光子 AI 加速器具有软件编译器层,可将标准 PyTorch 和 TensorFlow 计算图转换为光学相位配置,而无需修改原始代码。
光子人工智能何时会成为商业数据中心的标准?
混合电光子加速器已经进入专门的云设施,随着硅光子制造实现批量均等,预计未来几年将在企业集群中进行广泛的商业部署。