光ニューラル ネットワーク: フォトニック AI コンピューティングの夜明け
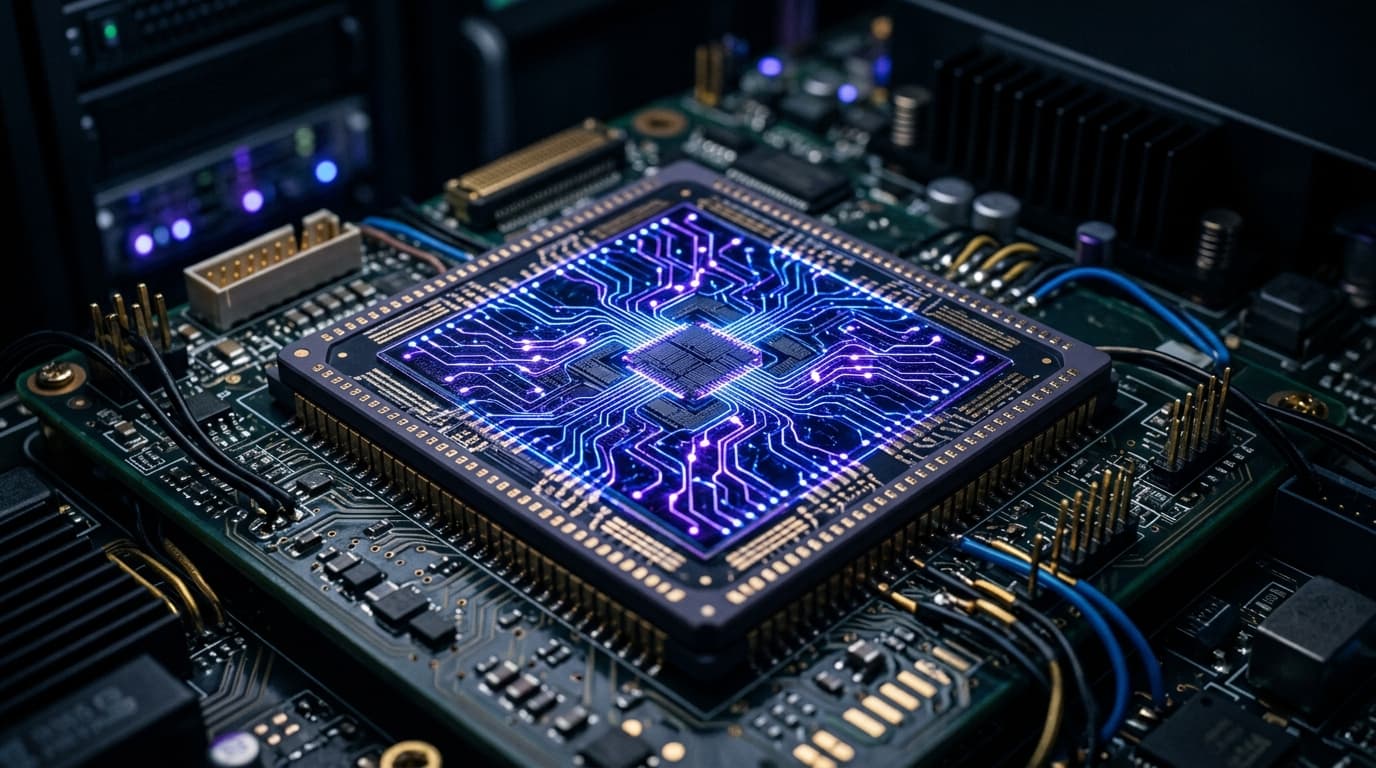
人工知能の爆発的な成長により、従来のシリコンマイクロエレクトロニクスは物理的限界の瀬戸際に追い込まれています。最新の変圧器アーキテクチャと兆パラメータの基礎モデルは、過剰な熱を発生させると同時に膨大な電力を消費し、世界のデータセンターの持続可能性を脅かしています。シリコンのボトルネックを打破するために、コンピューター科学者と物理学者は、根本的に高速な媒体である光に目を向けました。シリコン フォトニクスを利用した光ニューラル ネットワーク (ONN) は、人工知能の加速における根本的なパラダイム シフトを表します。
光子でムーアの法則を破る
何十年もの間、コンピューティングの進歩は、ムーアの法則に従って電気トランジスタを縮小することに依存していました。しかし、トランジスタの寸法が原子スケールに近づくにつれて、量子トンネリングと熱散逸によりクロック周波数に厳しい物理的制限が課せられます。微細な銅配線に沿って電子を伝送すると、必然的に抵抗、遅延、電力の無駄が発生します。
対照的に、光子は電荷を持たず、光の速度で移動します。光ニューラル ネットワークでは、数学的演算、特に深層学習推論の大部分を構成する行列乗算は、電子スイッチングではなく、光波の物理的干渉、回折、位相変調を介して実行されます。
光による瞬時行列乗算
深層学習モデルは積和演算 (MAC) 計算に大きく依存しています。電子 GPU では、数百万の論理ゲートが同時に切り替わり、これらの線形代数テンソルを計算するためにギガワットの電力を消費します。
フォトニック テンソル コアでは、レーザー ビームのアレイがシリコン チップ上に統合されたマッハ ツェンダー干渉計 (MZI) のメッシュを通過します。電気光学材料を使用してマイクロ導波路の屈折率を変更することにより、この回路は光の位相と強度を変調します。光波が干渉計アレイから発せられると、ほぼゼロの熱放散で行列の乗算が本質的に瞬時にすでに行われています。
天文学的なエネルギー効率と超低遅延
光学式 AI コンピューティングの運用上の利点は次のとおりです。
- サブナノ秒遅延: 光はシリコン導波路中を毎秒約 80,000 キロメートルで移動し、銅配線よりも桁違いに速い推論速度を実現します。
- 波長分割多重 (WDM): 単一の光導波路を通る光の異なる色 (波長) にわたって複数の独立した計算を干渉することなく同時に実行でき、大規模な空間並列性を実現します。
- 大幅な熱削減: フォトンは電気抵抗を生成しないため、光コンピューティング コアは低温のままであり、現在高密度データ センターの大半を占めている膨大な冷却コストが大幅に削減されます。
共同パッケージ化された光学素子と商品化への道
純粋な光学式の汎用コンピュータは開発中ですが、ハイブリッド電子写真アーキテクチャはすでに商業的な実用性を見出しています。 Co-Packaged Optics (CPO) は、フォトニック テンソル エンジンを従来のメモリ コントローラーや CPU とともに統合します。このハイブリッド エコシステムでは、高速光チップがマトリックス演算を処理し、従来のデジタル コントローラーがメモリ アクセスと非線形活性化機能を調整します。
シリコンファウンドリの製造技術が成熟するにつれて、フォトニック加速は、リアルタイムのエッジロボティクス、自律型航空宇宙システム、および次世代の惑星規模の AI クラスターの基礎インフラとなるでしょう。
よくある質問
光学ニューラル ネットワークは電子 GPU とどう違うのですか?
従来の GPU は、トランジスタを流れる電流を使用して数学的計算を実行するため、熱と遅延が発生します。光ニューラル ネットワークは、光変調器を通過する光ビームを使用して、電気抵抗なしでほぼ瞬時に行列方程式を計算します。
光学チップは PyTorch や TensorFlow などの既存の AI ソフトウェアを実行できますか?
はい。最新のフォトニック AI アクセラレータは、元のコードを変更することなく、標準の PyTorch および TensorFlow 計算グラフを光位相構成に変換するソフトウェア コンパイラ レイヤーを備えています。
フォトニック AI が商用データセンターの標準になるのはいつですか?
ハイブリッド電子フォトニクス アクセラレータはすでに専門のクラウド施設に導入されており、シリコン フォトニクス製造が量的同等を達成するにつれて、今後数年間でエンタープライズ クラスタ全体に広範囲に商業展開されることが予想されます。